La publicación detalla tiempos de inferencia para los tres modelos y subraya que el objetivo no era solo sacar tokens, sino evitar que el driver Vulkan se cayera al mover activaciones entre GPUs de distintos fabricantes y con anchos de banda muy reducidos. Eso convierte el caso en una prueba práctica de cuánto puede tolerar una pila de inferencia flexible antes de romperse.
Qué ha mostrado exactamente
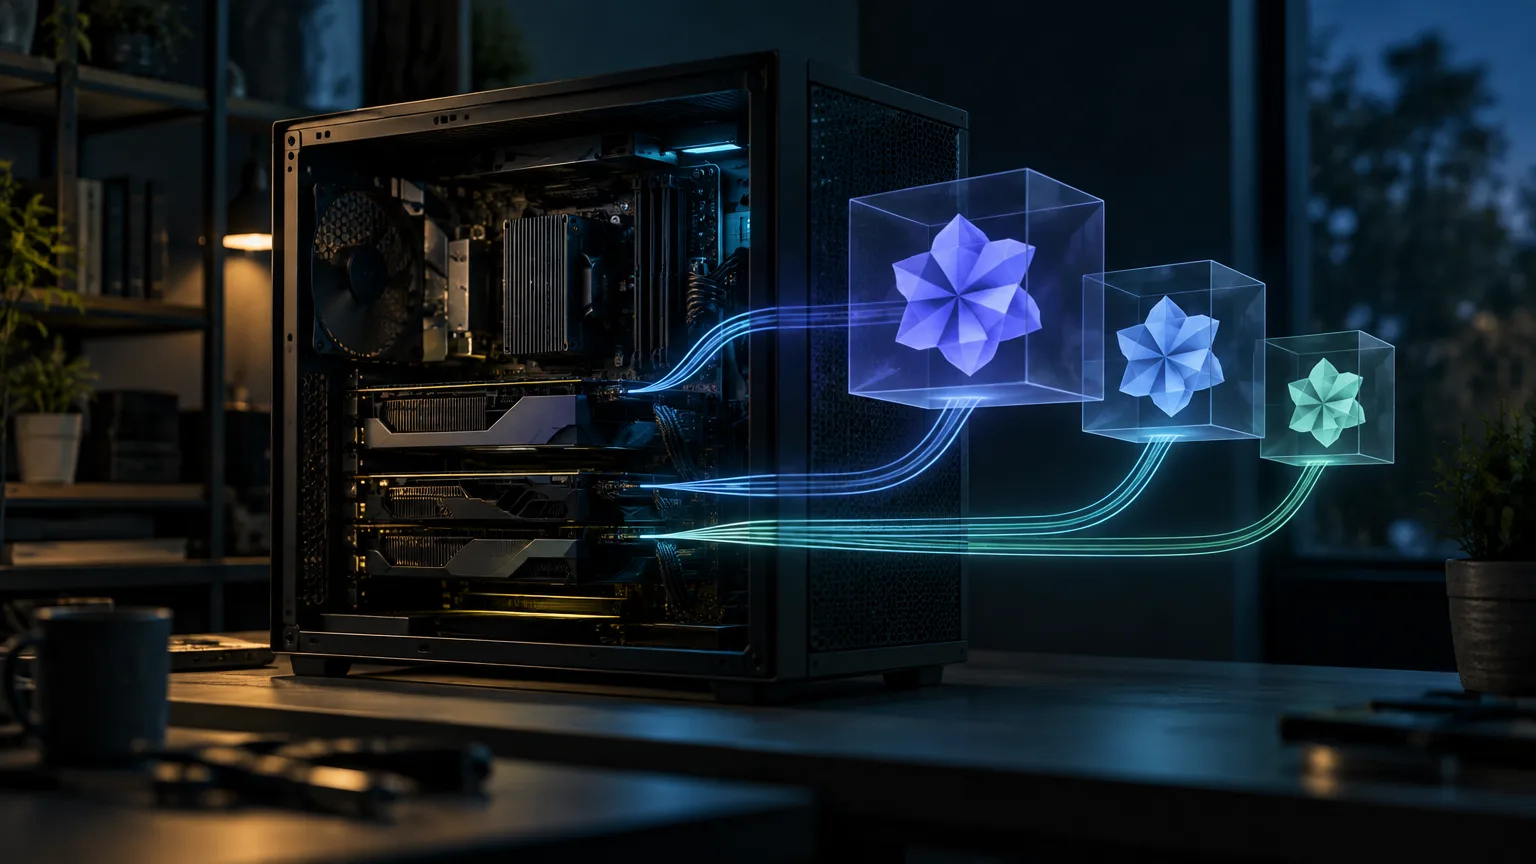
El sistema descrito, llamado `lvgale`, mezcla un Intel Core i7-6700K con cuatro GPUs: una AMD RX 580 de 8 GB por PCIe x16, una AMD RX 570 de 8 GB por PCIe x1, una NVIDIA GTX 1660 Super de 6 GB por PCIe x2 y una NVIDIA GTX 1070 de 8 GB por PCIe x1. La parte relevante no es solo el número de tarjetas, sino la forma en que están conectadas: varias de ellas trabajan con un caudal de datos muy inferior al habitual para cargas de inferencia de modelos grandes.
El autor explica que las activaciones deben viajar entre arquitecturas AMD y NVIDIA a través de enlaces estrechos, lo que crea un cuello de botella serio. Aun así, sostiene que el sistema puede servir consultas de visión y OCR de manera simultánea sin perder estabilidad. En esa descripción, la palabra clave no es velocidad, sino continuidad operativa: mantener el servicio vivo en un entorno que, sobre el papel, parece diseñado para fallar.
Rendimiento medido, no rendimiento prometido
La publicación aporta tres cifras concretas de inferencia concurrente: Qwen3.8:27b-vision a 3,82 tokens por segundo, Qwen3.5:9b-vision a 4,75 tokens por segundo y Qwen3.5:2b-vision a 12,47 tokens por segundo. Son resultados autoinformados por quien ha montado el sistema, así que conviene leerlos como una medición puntual de ese hardware, no como una referencia generalizable.
Aun con esa cautela, las cifras sirven para entender la distribución del coste computacional. El modelo de 2B corre bastante más rápido que el de 27B, algo esperable, pero la parte interesante es que el 27B no se limita a arrancar: se mantiene estable en un escenario donde la comunicación entre GPUs es el principal obstáculo. Para un montaje de este tipo, la estabilidad ya es una parte del éxito.
Slipstream y una pila pensada para sobrevivir al desorden
La publicación atribuye el enrutado de trabajo a Slipstream, un motor de orquestación en Python compilado con Nuitka, que utiliza un backend Vulkan multivendedor y Flash Attention para sostener la ejecución. En otras palabras: la arquitectura de software intenta compensar con coordinación lo que el hardware no ofrece en limpio.
Eso importa porque este tipo de montajes no dependen solo de la potencia bruta de cada GPU, sino de cómo se reparten capas, contexto y activaciones entre tarjetas que no fueron diseñadas para trabajar así. En entornos homogéneos, ese problema suele ocultarse; aquí queda expuesto. El mérito técnico, por tanto, no es únicamente que el sistema funcione, sino que lo haga sin desestabilizar el driver durante tareas de OCR y análisis visual complejo, que son precisamente las que más castigan la cadena completa.
Qué puede aprenderse de este caso
Este ejemplo no demuestra que PCIe x1 sea una vía razonable para desplegar modelos grandes en producción. Sí muestra que, con suficiente ingeniería de orquestación, un sistema puede aprovechar hardware reciclado o fragmentado para sostener cargas que normalmente exigirían una plataforma más coherente. Para laboratorios pequeños, proyectos personales o pruebas de tolerancia de software, esa es una lección útil: la limitación del bus no siempre impide el servicio, pero obliga a rediseñar muy bien cómo circulan los datos.
También deja una advertencia implícita. Cuando una inferencia distribuida depende de diferentes fabricantes, enlaces estrechos y una pila personalizada, la portabilidad y la repetibilidad pasan a ser el verdadero reto. El resultado puede ser impresionante en un nodo concreto y mucho menos reproducible en otro parecido. Sin documentación adicional, no puede asumirse que el mismo comportamiento se repita fuera de esa configuración.
La propia publicación remite a documentación técnica más amplia del motor, pero lo que queda confirmado por ahora es más modesto y, a la vez, más interesante: un montaje físicamente poco ortodoxo ha conseguido servir tres modelos Qwen al mismo tiempo y mantener la estabilidad del sistema. Falta por saber hasta dónde escala Slipstream cuando se somete a más carga, más sesiones o más tráfico concurrente.